
主题
Codex 模型繁忙处理
1. 识别容量提示
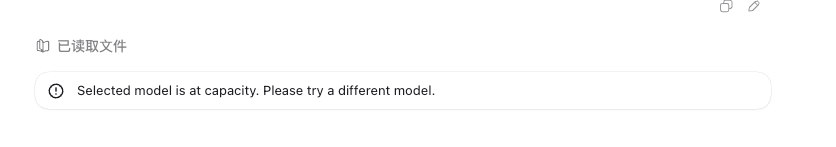
当看到 Selected model is at capacity. Please try a different model.,表示当前模型的可用容量暂时不足,并不代表本机安装或令牌配置一定有问题。
2. 处理步骤
先根据提示做判断:
| 现象 | 优先检查 |
|---|---|
Selected model is at capacity | 切换模型或渠道,稍后重试 |
| 登录页面打不开或请求超时 | 网络环境、代理规则和直连设置 |
| 未授权、令牌无效或权限不足 | 令牌是否过期、分组是否正确、当前配置是否已启用 |
| 请求频率限制(429 类提示) | 降低并发,加入退避重试 |
| 上下文超限提示 | 精简对话或拆分任务,见《上下文管理实战》 |
| 模型不存在或无权限 | 模型 ID 是否写全、令牌分组是否包含该模型 |
容量提示和认证、网络错误是不同问题。不要因为容量不足就反复重装客户端或重新生成令牌。
2.1 切换模型或渠道
选择当前可用且延迟较低的模型或渠道后重试,例如可选择控制台监控中状态正常的 gpt-5.6-terra。怎么按任务难度挑选替代模型,见《效率与省钱技巧》第 1 节。
2.2 短暂等待后重试
等待 1 到 3 分钟,避免立即连续发起大量相同请求。容量通常会随着队列恢复而变化。
2.3 降低并发与增加退避
脚本或批量任务应降低同时发起的请求数,并在失败后使用递增等待时间重试。
text
第 1 次失败:等待 2 秒
第 2 次失败:等待 5 秒
第 3 次失败:等待 10 秒
一个带指数退避的 Bash 示例,可以直接套用在批量脚本里:
bash
#!/usr/bin/env bash
max_retry=5
delay=2

for i in $(seq 1 "$max_retry"); do
  if codex exec "你的任务描述" >> codex-run.log 2>&1; then
    echo "第 $i 次尝试成功"
    exit 0
  fi
  echo "第 $i 次失败,${delay}s 后重试"
  sleep "$delay"
  delay=$((delay * 2))
done

echo "连续 $max_retry 次失败,请人工检查 codex-run.log"
exit 1
重试时保留原始错误文本和发生时间,便于在控制台对照用量记录;连续失败超过几分钟,再更换模型或渠道。
3. 预防措施
- 批量任务错峰执行。避开使用高峰(通常是工作日的白天时段),把大批量任务安排在夜间或清晨。
- 任务拆小。单个任务越大、占用容量越久,越容易撞上容量限制;拆成小步既稳定又便于复盘。
- 准备备用模型。提前在令牌分组中确认 1 到 2 个能力相近的替代模型,出问题时不用临时查资料。
- 监控用量与状态。定期查看 STJAPI 控制台的使用记录和模型状态,异常早发现。
4. 仍无法使用时
检查 STJAPI 控制台中的令牌状态、分组和用量记录。如果网页本身无法打开,先按 STJAPI 账户与网络设置 排查网络连接。其他客户端的通用报错,见《通用排错手册》。